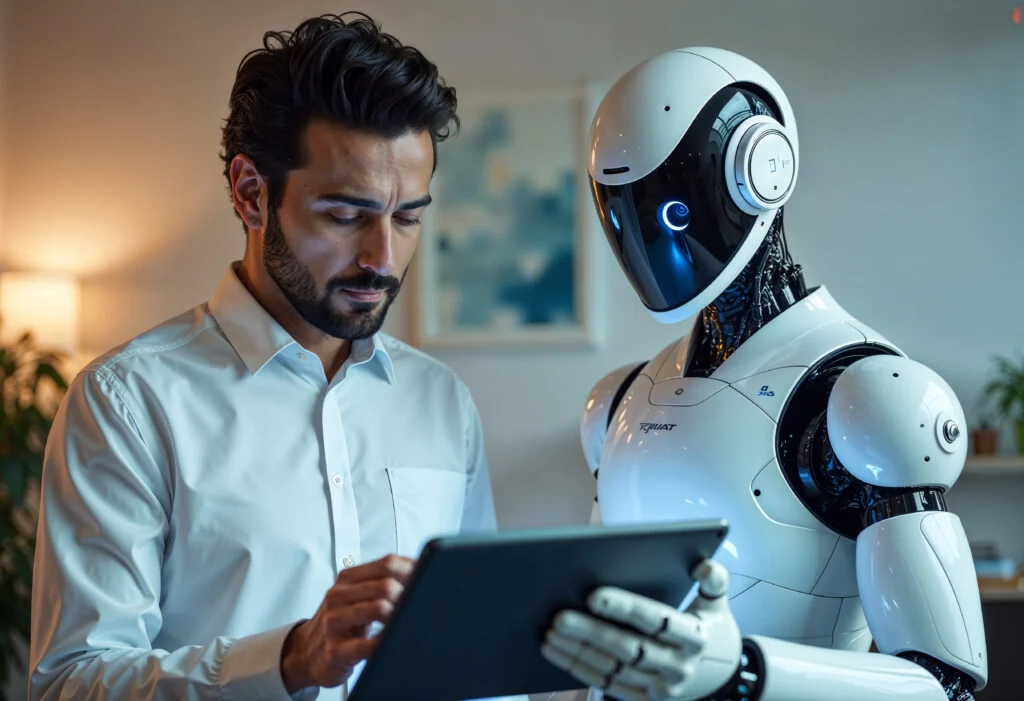
A inteligência artificial (IA) generativa está transformando empresas globalmente, mas essa inovação traz consigo um desafio crítico: a segurança dos dados usados para treinar esses modelos. Um dos riscos mais insidiosos é o data poisoning em IA, um tipo de ataque que corrompe bases de dados de forma quase imperceptível, influenciando negativamente o comportamento dos modelos. Caroline Maneta, da Dell Technologies, detalha como esses ataques funcionam e como proteger os dados corporativos.
Adicione ao Google NotíciasNeste artigo
- O que torna o data poisoning tão difícil de detectar em modelos generativos?
- Em qual ponto da cadeia de treinamento dados contaminados podem ser inseridos?
- Dados públicos e proprietários: qual a diferença ao serem manipulados?
- Quais as técnicas mais usadas para contaminar dados de IA?
- Como os ataques persistem mesmo com novas iterações do modelo?
- Quais manipulações podem ser feitas com um dataset adulterado?
- É possível direcionar o comportamento de um modelo com dados tóxicos?
- Como empresas protegem seus pipelines de dados contra o data poisoning?
- Quais frameworks de segurança e auditoria são eficazes contra esses riscos?
- Criptografia e rastreabilidade são suficientes para evitar o data poisoning?
- O data poisoning pode ser considerado um ataque à cadeia de suprimentos digital?
- Perguntas Frequentes sobre Data Poisoning em IA
O que torna o data poisoning tão difícil de detectar em modelos generativos?
Data poisoning em IA é um ataque que envolve a inserção ou alteração de dados nos conjuntos de treinamento de modelos de IA.
O objetivo é manipular o comportamento do modelo, seja enviesando respostas, criando "portas dos fundos" para acionar respostas específicas, ou simplesmente degradando a qualidade geral do modelo.
Por que é tão complicado identificar esse tipo de ataque?
Existem três razões principais. Primeiro, os modelos generativos são treinados com vastas quantidades de dados diversos, tornando inviável a verificação manual ou automática de cada informação.
Segundo, os efeitos das manipulações são frequentemente sutis e dispersos, resultando em pequenas mudanças que afetam o modelo de maneiras complexas, manifestando-se apenas em situações específicas.
Terceiro, os conjuntos de dados são provenientes de diversas fontes e estão em constante mudança, com pipelines iterativos, o que significa que dados contaminados podem se espalhar e influenciar versões futuras do modelo sem deixar rastros claros.
Em qual ponto da cadeia de treinamento dados contaminados podem ser inseridos?
A contaminação pode ocorrer em quase todas as fases do ciclo de dados.
Desde a coleta e entrada dos dados, passando pelo processamento e curadoria, até o armazenamento e ajuste dos conjuntos usados no treinamento.
Como esses dados passam despercebidos?
No pré-processamento, scripts automáticos são usados para limpar e filtrar os dados, mas é possível burlar esses sistemas usando formatos ou tokens que escapam das regras.
No armazenamento intermediário, a falta de auditoria permite a alteração ou inserção de amostras sem que sejam notadas.
Durante o ajuste fino (fine-tuning), dados falsos podem ser injetados para mudar o comportamento do modelo de forma sutil.
O problema é que os sistemas geralmente confiam demais nas fontes dos dados e monitoram apenas o desempenho, negligenciando a integridade real dos dados que entram. Sem verificação de origem e auditoria automática, a contaminação pode passar despercebida em meio a grandes volumes de dados legítimos.
Dados públicos e proprietários: qual a diferença ao serem manipulados?
Dados públicos são alvos mais fáceis, pois qualquer pessoa pode acessá-los, e eles entram automaticamente nos pipelines.
Isso os torna particularmente perigosos na fase de pré-treinamento, embora o impacto possa ser diluído entre muitos modelos.
Já os dados proprietários têm uma superfície de ataque menor, mas se um invasor obtiver acesso interno ou comprometer a curadoria, o dano pode ser significativo.
Amostras direcionadas podem distorcer respostas, vazar segredos ou introduzir vieses em sistemas críticos. O data poisoning em IA é difícil de detectar porque explora a falta de auditoria nos próprios dados, aproveitando-se da confiança e da complexidade dos pipelines de treinamento.
Quais as técnicas mais usadas para contaminar dados de IA?
As técnicas variam desde a inserção direta de exemplos manipulados no treinamento dos modelos até a contaminação de modelos ou checkpoints usados no fine-tuning.
Atacantes também criam exemplos adversariais que exploram fraquezas do modelo, manipulam rótulos ou o feedback humano, e até sabotam a cadeia de suprimentos de dados, como repositórios, scripts de ingestão ou serviços de anotação.
Ataques também ocorrem em produção, com entradas maliciosas na inferência para forçar o sistema a agir de maneira indesejada.
Em resumo, os ataques visam dados, modelos, rótulos e infraestrutura em todas as etapas para provocar erros, vieses ou vazamentos.
Para proteger seus dados, a Claro Empresas lança APIs para combater fraudes em cadastros de usuários.
Como os ataques persistem mesmo com novas iterações do modelo?
A persistência é garantida através da implantação de backdoors com gatilhos que disparam comportamentos específicos mesmo após re-treinamentos.
Outra técnica é a contaminação de checkpoints ou modelos-base que são reutilizados por outras equipes.
A reintrodução ou "reossificação" de dados maliciosos em pipelines sem versionamento ou auditoria também contribui para a persistência.
Além disso, o comprometimento dos fluxos de anotação garante que a contaminação se repita em futuras iterações.
Atacantes miram em modelos, checkpoints, dados e processos de curadoria para assegurar que o problema persista ao longo do tempo.
Quais manipulações podem ser feitas com um dataset adulterado?
Um dataset adulterado pode induzir vieses ideológicos e degradar a precisão técnica e a consistência do modelo.
Pode também implantar backdoors que retornam respostas programadas a gatilhos específicos e fazer com que o modelo memorize e exponha informações sensíveis.
Além disso, pode provocar contaminação cruzada que afeta múltiplos modelos derivados.
É possível direcionar o comportamento de um modelo com dados tóxicos?
Sim, dados manipulados, especialmente quando alteram exemplos de treinamento, rótulos ou feedbacks, podem influenciar um assistente ou recomendador a favorecer certos conteúdos.
Isso pode resultar na reprodução de vieses, na execução de ações indesejadas ou no disparo de respostas predefinidas por um gatilho.
Como empresas protegem seus pipelines de dados contra o data poisoning?
Empresas devem manter controles contínuos de integridade e auditoria nos pipelines, incluindo validação automática dos datasets.
É importante também versionar e verificar a origem dos dados, segmentar o acesso (RBAC), criptografar os dados em trânsito e em repouso, e monitorar anomalias durante o treinamento.
Adicionalmente, é necessário fortalecer os ambientes de orquestração e aplicar controle rígido sobre quem pode inserir ou alterar dados.
Automatizar checagens e limitar privilégios são medidas importantes para reduzir riscos. Soluções que oferecem automação na proteção e recuperação de ambientes críticos, como os pipelines baseados em Kubernetes, também são recomendadas.
Quais frameworks de segurança e auditoria são eficazes contra esses riscos?
Os principais frameworks que tratam do risco de data poisoning em IA são o NIST AI RMF e a ISO/IEC 42001.
O NIST AI RMF foca em identificar e mitigar ameaças ao longo do ciclo de vida do modelo, incluindo auditoria dos dados, rastreabilidade e integridade, tratando o poisoning como um ataque à cadeia de suprimentos.
A ISO/IEC 42001 define políticas de governança para garantir qualidade, explicabilidade e revisão contínua das fontes de dados.
Juntas com a ISO/IEC 27001, que cobre segurança da informação, essas normas ajudam a proteger os pipelines com rastreabilidade, versionamento e validação sistemática dos dados.
Criptografia e rastreabilidade são suficientes para evitar o data poisoning?
Criptografia e rastreabilidade ajudam a diminuir o risco de adulteração, mas não impedem a inserção de dados maliciosos que parecem legítimos.
Para uma proteção eficaz, é necessário ter curadoria ativa, validação semântica dos dados, auditoria dos pipelines e monitoramento constante de comportamentos estranhos durante o treinamento e a inferência.
O data poisoning pode ser considerado um ataque à cadeia de suprimentos digital?
Sim, o data poisoning em IA explora falhas e vulnerabilidades em várias etapas do processo de coleta, curadoria e integração dos dados usados para treinar modelos de IA.
Ele pode ocorrer desde a coleta de dados em repositórios abertos e públicos até a reutilização de modelos pré-treinados por outras equipes.
Esses pontos fazem parte da cadeia de suprimentos digital da IA, e qualquer falha neles pode comprometer a confiabilidade, segurança e desempenho do modelo final.
Perguntas Frequentes sobre Data Poisoning em IA
O que é Data Poisoning em IA e por que é perigoso?
Data Poisoning em IA é um tipo de ataque onde dados maliciosos são inseridos em conjuntos de dados de treinamento de modelos de IA, com o objetivo de manipular seu comportamento. Isso pode levar a vieses, erros e até vazamento de informações sensíveis.
Como as empresas podem se proteger contra ataques de Data Poisoning em IA?
Empresas podem se proteger implementando controles rigorosos de integridade e auditoria em seus pipelines de dados, incluindo validação automática, versionamento, verificação da origem dos dados, segmentação de acesso e monitoramento contínuo de anomalias.
Quais são os frameworks de segurança recomendados para mitigar riscos de Data Poisoning em IA?
Os frameworks de segurança mais recomendados são o NIST AI RMF e a ISO/IEC 42001, que fornecem diretrizes para identificar e mitigar ameaças ao longo do ciclo de vida dos modelos de IA, além de garantir a qualidade e a rastreabilidade dos dados.
Via TI Inside